如何讓計算機學會周易取象---兼談對人工智能研究的一些認識
對很多人來說,讓計算機也學會取象,這個聽起來很玄,其實這事一點也不難,明白了原理也就簡單了。
易學中的類象,從抽象的角度來說,其實就是一種對於萬事萬物的歸類,由於聖人觀陰陽之開闔以命物的緣故,人類在對客觀世界中所感知的事物進行起名的時候,總會依照某種直覺性的規律。
而這種規律是超越語言性的,在近代來的研究的語言翻譯模型,也能夠能夠發現類似的有趣情況,針對兩種語言之間的翻譯的模型,可以遷移到另外兩種語言之間進行一些調整然後加以使用。
這意味著其實人類的語種,在語法及結構上,看起來似乎很大的差別,但背後超越了符號的直覺是一致的,因此對於符號之間的組織方式都會暗合某種統一的規律。
還有使用如GPT之類的模型進行人類語言的文本生成的時候,能夠進一步發現,語言模仿一個作家的風格行文是一種很容易的事,所謂的不同風格,其實就是語句偏愛於使用哪些詞語來進行語句的組織,另外就是給事物加上多少個維度的描述,這也符合某種分佈,一旦捕捉到了這些,可以很容易地對語言進行模仿。
甚至包括人的世界觀、價值觀、人生觀,所塑造出來的思想而反映出來的說話模型,從數理角度上看,也只是一種概率分佈形式。
一個典型的例子便是有人對紅樓夢裡面的人物對話進行了訓練,然後模型能夠推斷對話是由什麼人物所說,正確率極高。
相應的,對於紅樓夢非常熟悉的人,儘管背不出紅樓夢,但是看到某些對話時,也能憑感覺猜出來是誰說的。
因此反過來,對於人來說,語言風格是一種“感覺”,而這種“感覺”能夠讓人在寫與讀時共同得到“感受”,人類的這種感覺,本質上是對特定概率分佈的感知。
這是一種非常奇妙的情況,這意味著,人類通常在閱讀一兩句話時,往往能夠迅速從感覺上捕捉到這種分佈,然後進行判斷,這個過程很有可能不是通過物理運算進行的,而是通過生化機制進行的。
有時候說嬰兒出生下來是一片白紙,這種說法不夠正確的,從模型思維上來看,嬰兒更像是事先擁有了一個巨大的可進行調整的模型,對於這種模型的訓練,因此能夠快速地進行學習。
但這種學習得越多, 模型就會變得越加定型化,因此人會產生各種思維定勢,並被限制在某些看不見的桎梏中,因此在道家會要求,修道都需要像嬰兒一樣進行學習,這其實就是力圖擺脫後天遷移的影響,迴歸到天然的模型上去,從而能夠擁有更強的學習能力。
無論是八卦類象,還是十天干類象,或是各門術數中獨有的符號名稱的類象,都可以理解為一種歸類的方法。
易學中最神奇的是這類歸類方法具有很強的相通性,比如只要是按十天干命命的,無論它在什麼樣的易學模型中進行組織與運算,它本身的類象仍然是相同的,這意味著在不同的術數模型中,類象的劃分仍然會是一致的,有極強的通用性。
人類的語言背後既然有一種統一的規律,那麼類象的劃分必然也可以與這種規律相互對應。
但另外還有一個問題是,類象的歸類也要考慮到不同的場景下詞語發生變化的可能,如現代網絡時代出現的很多新網絡詞彙,例如像抨擊社會現象的“時間管理大師”,這便有多重含義,另外還有一些情況,比如有時候諧音字也可以用取象,雖然應用頗多,但這是否足夠合理,還需要進行驗證。
因此這只是一個初步的測試,方便比較簡單,直接加載Bert的詞向量模型後,然後進行文本分類,例如類象這樣的描述:
君,乾父,乾大人,乾老人,乾長者,乾名人,乾公門人,乾金玉,乾寶珠,乾圓物,乾木果,乾剛物,乾冠,乾鏡,乾公堂,乾樓臺,乾高堂,乾大廈,乾
簡單來說就是將將卦名視作類象的分類名稱,通過整理好的訓練集在經過6000次訓練,在訓練到1500次的時候,訓練集的正確率已到達近75%
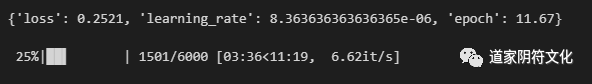
對於會不會產生過擬合的現象,如果訓練數據中存在有不正確的數據,或是給出來的關鍵詞有不準確的情況下,過擬合才會產生問題,如果有一份足夠好的基礎數據用於訓練,則不需要太過於擔心過擬合問題。
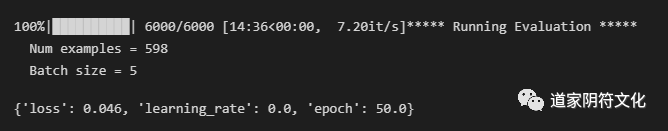
錯誤率僅有0.046,這意味著約有94.4%的準確率,雖然還並不夠高,但可以將就用了。
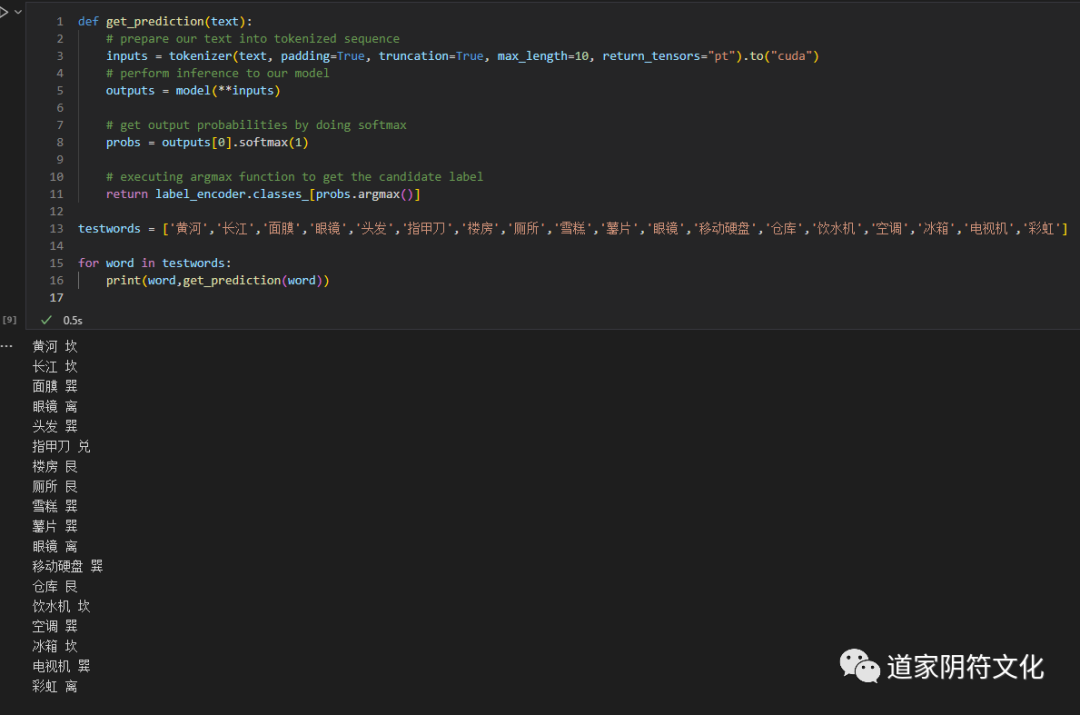
用一組詞組進行實驗,可以看到,確實能夠對事物起到歸類的效果,比如能夠正確辨認出“黃河"、"長江"屬於水的。
再隨便測試幾個:
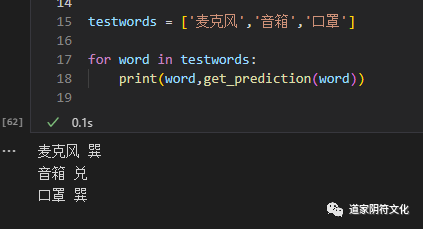
歸類的效果還是令人滿意的。
這個有什麼用?比如說,有時候不知道某個現實的事物屬於哪個卦時,便可以使用這樣的系統幫助進行推斷,甚至配上一個文本生成器,設計好句式的話,它甚至能描述出斷語出來,當然,這個事會更加複雜一些,目前並不容易實現。
值得一提的是,在提出來做這個時,有人提出可以用焦氏易林的象來做,然而經過測試,發現效果極差,模型最多隻能收斂到百分之六十幾。
後來找了一下這份類象的出處,再翻了一下尚秉和著的《焦氏易林注》,發現這份類象表有嚴重的問題。
首先尚秉和著的《焦氏易林注》中提煉象時,並不是針對單個卦進行提煉的,因為《焦氏易林》中的每一組都是兩上六十四卦,而在解構時,並非是單純的採用單個卦的解析關係,因為兩個六十四卦,除了可以拆分為四個卦外,還可以進行互卦拆分、錯卦拆分,然後形成至少八個卦之間的關係進行相互運算,因此它是一個整體的關係來進行的取象。
如果簡單的視作單個卦來進行解讀的話,必然會出現難以挖掘的情況,而當初提煉這份類象表的人,只是用計算機代碼去掃描了一下《焦氏易林注》中的詞語,然後進行了分詞提取,因此得到的歸類的卦象本身會有極多的衝突,因此放在模型上,結果便不能很好地進行收斂。
這也給了一個更加可靠的驗證的反向驗證,那就是並非是所有的詞組可以隨意地放在一起隨便歸類,背後依然會依照一些原則,也可以說,傳統的基本歸類方法是確實有效的。
之來又實驗一下十天干的類象,效果依然不錯,這裡便不一一貼圖了,回頭會考慮再做下相對更加豐富的地支類象。
這只是一時興起所做的研究,如果大家有什麼想法,歡迎在評論中指出。