最新手札
使用OpenResty及Redis實現API池,進行動態分配請求及隊列等待及超時處理
為了提供一個完整的實現方案,我們將詳細說明如何使用OpenResty和Redis來構建一個系統,該系統不僅能夠根據QPS限制動態分配請求,還能在超出QPS限制時將額外的請求放入隊列中等待處理,並設置超時機制。 完整實現步驟 1. 環境準備 確保你已經安裝了以下組件: OpenResty :Nginx的一個擴展版本,支持Lua腳本。 Redis :用於存儲API QPS限制、計數以及排隊請求的信息。
下載llama.cpp的llama-b3982-bin-ubuntu-x64.zip,在ubuntu上提示libstdc++.so.6: version `GLIBCXX_3.4.30' not found 及 /lib64/libc.so.6: version `glibc_2.32' not found 的解決方法
對於 libstdc++.so.6: version `GLIBCXX_3.4.30' not found sudo add-apt-repository ppa:ubuntu-toolchain-r/test sudo apt-get update sudo apt-get install gcc-4.9 sudo apt-get upgrade libstdc++6 對於第二個/lib64/l
flash-attention
liunx https://github.com/Dao-AILab/flash-attention/releases win https://github.com/bdashore3/flash-attention/releases
Llama3最簡便的下載及最簡便的使用方法
1、下載 Ollama 在 Ollama 的網站:https://ollama.com/library/llama3 上查看有哪些模型tag可用,例如要使用llama8b的base的4bit量化版本,可直接運行: ollama run llama3 建議使用微調過的量化版本,問答效果更佳。 ollama run llama3:instruct 即默認下載到本地,大小約4.7G,當運行後,已經可以在
stable-diffusion-web-ui中總提示urllib.error的解決
提示類似 urllib HTTP Error 403: Forbidden 時,找到 ui_extensions.py 文件,然後修改 refresh_available_extensions 下面的內容 def refresh_available_extensions(url, hide_tags, sort_column): global available_extensions import
QuIP方法量化方法的中的不相關性
QuIP量化方法中,有一個概念是不相關性的引入。 對於一個現成的模型參數,重新量化是將神經網絡中的權重矩陣從高精度表示(如32位浮點數)轉換為低精度表示(如2位或4位整數)的過程。這個過程可以顯著減小模型的存儲需求和計算複雜度,從而提高模型的運行效率。然而,量化過程可能會導致模型性能下降,因為低精度表示可能無法完全捕捉原始權重矩陣的信息。 QuIP方法通過引入權重矩陣和Hessian矩陣之間的不相
理解LDL分解的例子
例如一個原始矩陣: A = | 4 2 | | 2 5 | 可採用以下步驟來計算LDL分解 1、解始化一個單位下三角矩陣L,以及對角矩陣D L = | 1 0 | | l 1 | D = | d1 0 | | 0 d2 | 2、根據LDL分解的定義,我們有 A = L * D * L^T。我們需要找到合適的l和d值,使得這個等式成立。首先計算L和D的第一個元素: 4 = 1 * d1 * 1 +
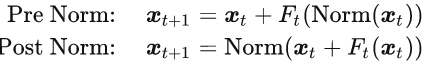 人工智能
Layer Norm 與 RMS Norm 的區別
Norm即Normalization,是對數據進行歸一化的一種操作,一般是將數據歸一化到“平均為0,方差為1”的分佈中,RMS Norm相比Layer Norm少了一個除以平均數的步驟。 Layer Norm即是直接對層進行正則化,一般有兩種,一個是事先正則化(pre norm),一個是事後正則化(post norm)。 事先正則化就是直接對於輸入進行正則化,然後再計算結果,事後正則化則是結果計算
人工智障啊
Chinese-Llama-2-7b-hf 極不靠譜,而且跑起來非常緩慢,經常會死掉 Chinese-Llama-2-7b-4bit 這個模型,直接笑了,而且輸出直接不帶停的,一直循環 什麼是夫妻肺片? 夫妻肺片是指夫妻之間的肺片,也就是夫妻之間的肺部結構。夫妻肺片是指夫妻之間的肺部結構,也就是夫妻之間的肺部結構......... chatGLM2-6B 也是不錯的 介紹下夫妻肺片? 夫妻肺片是一
windows11下使用deepspeed步驟
git clone https://github.com/microsoft/DeepSpeed.git 然後需要修改一下代碼: 1、打開目錄下文件:csrc/quantization/pt_binding.cpp 將其中第 203 行的 std::vector<long int> 改為: std::vector<long long> 2、打開目錄下的文件,csrc/transformer/inf
從ChatGPT的文字總結能力聯想到一點小思路
用幽默而直白的方式介紹DND中的各類種族: 矮人族:一群鐵匠和酒鬼的混合體,他們覺得生命的意義就是打鐵、喝酒,還有爭論哪種泡沫更好:啤酒泡沫還是洗澡泡沫。 獸人族:一堆大塊頭,見解通常是“如果不明白,就用力打”。他們曾試圖開辦餐館,但因為每道菜的烹飪步驟都是“砸、炸、煮、烤”,最後只好轉行當了破牆專家。 侏儒族:他們發明了各種詭異的機器,但常常會出現奇怪的故障。一次,一個自動切洋蔥的機器突然變成了
wget跳過ssl證書下載參數
僅用 wget --no-check-certificate 是不行的,需要使用: wget --secure-protocol=TLSv1_2 --no-check-certificate {url}
人工智能時代可能會興旺的職業
科技與信息技術行業 人工智能模型評估師 負責對人工智能生成的模型進行評估和測試,檢測其性能和效果,提供模型優化和改進的建議。 AI模型監督員 負責對人工智能生成的模型進行監督和管理,確保其在應用過程中遵循道德、法律和社會準則,防止不當行為和偏差。 數據集清洗師 負責對用於訓練人工智能生成模型的數據集進行清洗和處理,確保數據集的質量和準確性,優化模型的訓練效果。 人工智能生成內容編輯師 負責對由人工
Lora 與 P-Tune 兩種微調方法有什麼不同?
LORA和P-Tune都是微調(fine-tuning)機器學習模型的方法,但它們的具體實現方式有所不同。 LORA(Layer-wise Relevance Propagation)是一種基於層級相關性傳遞的微調方法。在LORA中,先計算出每個輸出特徵與輸入特徵之間的重要性權重,然後再通過這些權重來微調模型。這種方法可以幫助深度神經網絡模型更好地理解輸入數據的特徵,並提高模型的準確性。 P-Tu
環路神經網絡的一個Idea
環路神經網絡是一種特殊的循環神經網絡,它由多個不同長度的環組成,每個環都是一個循環單元,可以看作是一個簡化的LSTM或者GRU。每個環都可以捕捉數據中的一個特定頻率的週期性變化,而多個環的組合可以表示更加複雜的時序模式。 例如,如果我們想要對股票價格進行預測,我們可以設計一個由三個環組成的環路神經網絡,其中一個環的長度為5,表示每週的週期性變化,另一個環的長度為20,表示每月的週期性變化,最後一個
小試新訓練的AI模型生成的關於梅花易數的內容
梅花易數是一種簡單易學的占卜方法,它可以用來解答各種生活中的問題,比如工作、感情、健康等。梅花易數的原理是根據六十四卦的變化規律,通過隨機抽取梅花卡或者搖骰子等方式,得到一個卦象,然後根據卦象的內涵和現實情況,進行分析和判斷。 在這篇文章中,我將舉一個梅花易數的案例,一個人詢問工作,得到的是火天大有變地天泰。這個卦象是由大有卦變出泰卦,表示從富裕和成功的狀態轉變為和平和安定的狀態。具體來看,火天大
對五行關係進行建模並用BP進行反向求解
import numpy as np # 生克關係矩陣 matrix = np.array([ [0, 1, 0, 0, -1], [-1, 0, 1, 0, 0], [0, -1, 0, 1, 0], [0, 0, -1, 0, 1], [1, 0, 0, -1, 0] ]) # 每個元素之間的相互作用強度 weights = np.random.randn(5, 5) # 定義模型函數 def
ChatGPT的中文模型替代品:盤點目前最新的真正能在個人電腦上運行及可訓練中文模型
BELLE-LLAMA-7B-2M 早在很多人想到之前,貧道就開始有了中文訓練的想法,因此將斯坦福的數據集進行了中文翻譯後,然後作為中文語料去二次訓練LLAMA。 因此最早使用中文訓練的版本,是貧道用PEFT採用lora訓練的,上傳在了huggingface上,模型是 alpaca_7b_zh 這個模型有一個缺點就是運行速度會比較慢,在採用GPU推理時,它會瘋狂運算半天,然後才會輸出一個結果,大概
評點輔助Visual Studio Code開發的幾個AI代碼提示插件
1、 飛槳套件中的CodeGen 聲稱16B大小的模型超過了Open AI的代碼生成模型,看模型名稱是Salesforcer公司的,在huggingface上也提供了模型,在裡面翻 CodeGen 相關的就是,提供了不同大小的模型,在中國使用的直接用飛槳的會比較簡單,畢竟下載快,可使用FauxPilot插件,好且免費,需要自己配置一下,不過不算複雜。 2、 Amazon CodeWhisperer
pytorch國內鏡像
例:https://mirror.sjtu.edu.cn/pytorch-wheels/cu113/?mirror_intel_list
利用清華源的pip鏡像快速安裝transformers源碼
因為網絡的問題,因此如果下載源直接安裝極為麻煩,因此可以先用鏡像安裝 例如: pip install transformers -i https://pypi.tuna.tsinghua.edu.cn/simple 這樣依賴都已經安好 然後 pip uninstall transformers 然後再git clone https://github.com/huggingface/transfor
win11下bitsandbytes的用法
要將大模型進行量化加載,需要使用到bitsandbytes這個庫,但它原生是在Linux下安裝使用的,因此如果要在win11下使用,需要做一些修改。 在pip install bitsandbytes 之後,修改源代碼兩處。 一般安裝了conda後,目錄在:{driver}:\conda\envs\{name}\Lib\site-packages\bitsandbytes\ 下, 在pip ins
 人工智能
嚐鮮LLaMA的7B及13B模型
LLaMA有7B,13B,33B,65B,四種規格的預訓練模型,33B與65B需要的顯存量太大,所以無法嘗試,只能在3090卡上嘗試一下7B及13B的。 由於顯存的限制,所以使用了INT8加載模型的方案,主要用的是llama-int8來進行加載,這個的原理是將模型加載到內存中,然後再拷貝到顯存中。 13B模型,大概佔用了17G左右的顯存,而且運行速度並不太理想,實驗它的本文生成能力,也不盡人意,沒
 數據分析
神經網絡的一些簡單思考
簡單來理解一個模型,其實就是一個轉換器,或者說其實就充當了一個複雜函數的角色,能夠將輸入的數據轉換成另外一種形式呈現,如果轉換出來的數據形式對於相應的任務足夠直觀,那麼就很容易實現相應的任務。 從現在來看,元學習跟起初的構想已經產生了一些差異,最初的元學習構想的是讓機器學會如何學習,但這只是一個概念,實際上來看其實並沒有真正的達到這一點。 一般的遷移學習中,通常是先針對一個任務訓練出一個模型,然後
假如用鄰近矩陣表達五行生剋
對於五行的生,作為有一個有向環圖,可表達為: A B C D E A 0 1 0 0 0 B 0 0 1 0 0 C 0 0 0 1 0 D 0 0 0 0 1 E 1 0 0 0 0 對於五行的生,作為有一個有向環圖,可表達為: A B C D E A 0 0 1 0 0 B 0 0 0 1 0 C 0 0 0 0 1 D 1 0 0 0 0 E 0 1 0 0 0 很顯然,在鄰接矩陣的表達上,
chatGPT的一些意外的啟示
很多時候人類經驗很容易讓人忽視一些眼前的事情,但是採用人工智能往往能解決這個問題。 比如今天突然想到,如果chatGPT詢問了一個有趣的問題。 即模運算如何轉換成一個極運算 它的回答是: 模運算和極運算是兩個不同的概念,它們之間並沒有直接的轉換關係。 模運算是指取一個數的絕對值,並用它除以另一個數,得到餘數。例如,在整數運算中,“17 mod 3”的值為2,表示17除以3的餘數為2。 而極運算是指
Github Copilot的免費替代方案
對於visual studio code來說,一般可以考慮的是FauxPilot插件配合FauxPilot服務,然而FauxPilot插件安裝後其實並不好用。 更好解決方案是自己安裝FauxPilot服務後,然後安裝gitlab的插件,並修改其中代碼助手的地址,這樣便能進行對AI輔助寫代碼。 為了避免配置環境過於麻煩,可直接安裝百度的飛槳的paddleNLP,然後直接一行代碼運行其中的代碼輔助服務
conda清華源的配置
conda config --add channels https://mirrors.tuna.tsinghua.edu.cn/anaconda/pkgs/free/ conda config --add channels https://mirrors.tuna.tsinghua.edu.cn/anaconda/pkgs/main/ conda config --add channels ht
人工智能變聲器
Recast - Koe Recast 一個人工智能轉換語音效果的風格轉換器,可惜對中文語音的支持不是很理想,轉出來的風格,如同影視劇的外國人說中文說得不是很好的情況下的大舌頭感,對男聲及女聲都測試了一下,均不太滿意,然而,它對於英文的語音轉換,可以說做到了巔峰,甚至可以說,這才是大眾真正想要的變聲器。
python通過pip安裝失敗的或下載過於緩慢的萬能解決方案
直接訪問 https://pypi.org/simple/包名,下載whl進行安裝 例如安裝onnx,可直接訪問 https://pypi.org/simple/onnx, 餘仿此
GFPGAN所需用到的預訓練模型
RealESRGAN_x2plus.pth GFPGANV1.3 experiments\pretrained_models\ detection_Resnet50_Final.pth parsing_parsenet.pth gfpgan\weights 相關指令 推理 python inference_gfpgan.py -i inputs/whole_imgs -o results -v 1
 人工智能
百度一格的文本圖像生成
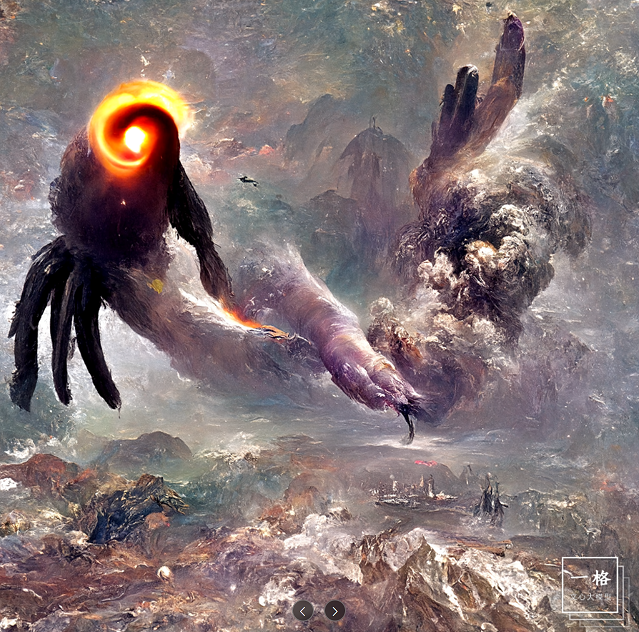
百度另外一個文本生成圖像接口,叫作一格,在這裡相對來說會更加自由,起碼可以生成超現實風格的圖片,並且這裡生成所花費的時間會更長,不過所生成的超現實風格的圖片,還是比較不錯的。
 人工智能
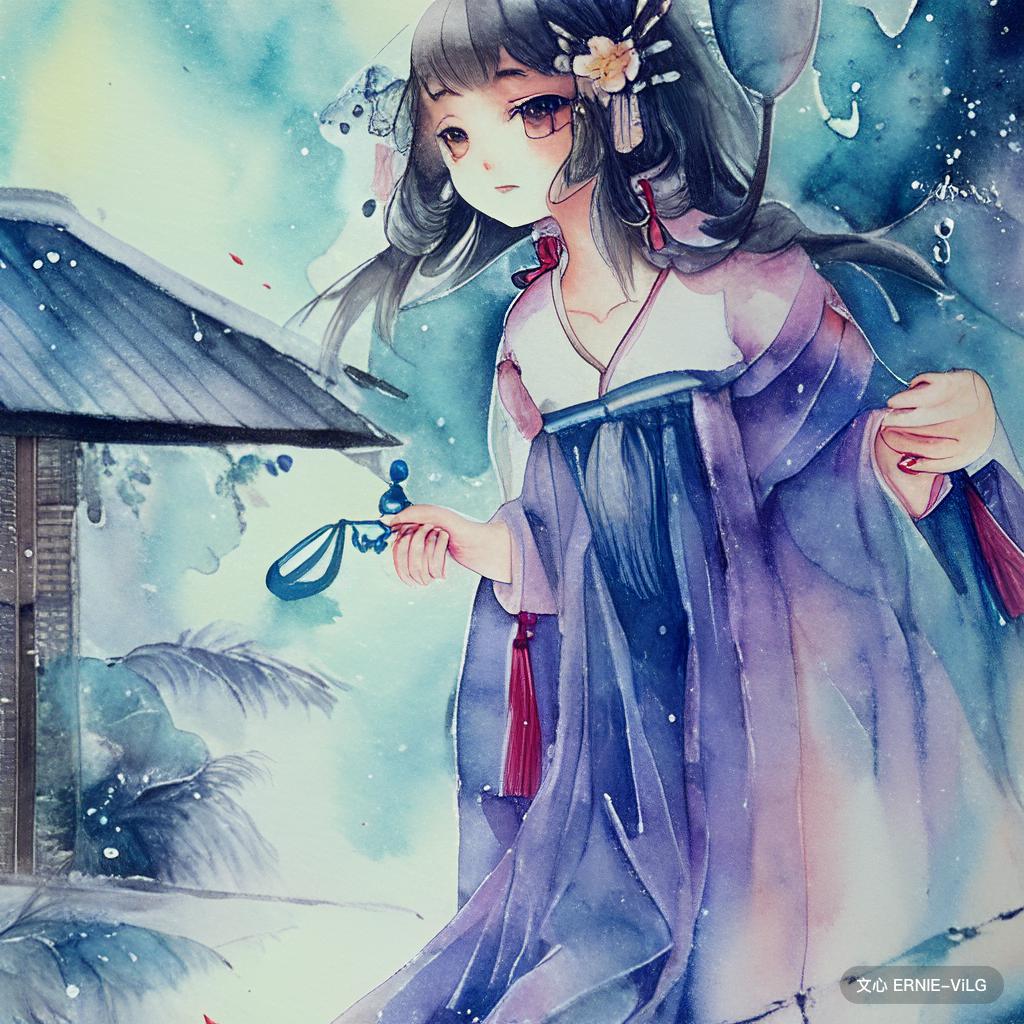
百度文心的文本圖像生成效果
可以看出生成還是比較有一些問題,人物的頭部仍然不夠理想,背景雖然還是很不錯的,服裝也很好,然而在臉上便不理想。 特別需要注意的是,當改成油畫風格後,生成的效果即對於人臉的仍舊是很難把控,,可以發現這有擴散模型的通病,但有時候也會生成還能接受的圖像,並且總體上相對來說卡通風格的人臉還可以接受。 因此關鍵詞中,嘗試考慮遮住臉,然而很遺憾的是,似乎文心並不能識別這樣的指令,然而意外的倒是其中得到了還算不
 數據預測
探討一般的生成式對抗網絡(GAN)難以模擬術數運算過程的原因
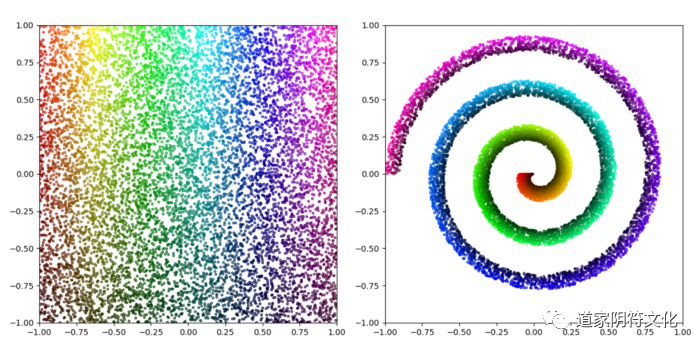
上一篇文中有人在一評論中提出是否可以利用生成式對抗網絡來對射覆的模擬,這個以前簡單實驗過一下,效果並不理想。 不理想是有原因,主要是一般的生成式對抗網絡的實現,本質上是從某個潛在空間到某個樣本空間的轉換或映射,對於高維數據的學習時,時常會表現出一些缺陷,從直覺上來說,通常它無法很好地模擬循環與週期的概念。 比如試圖學習的是這樣一個清晰的分佈。 而實際上訓練出來的結果卻是這樣: 而且這個並不能進一步
 數據預測
如何讓計算機學會周易取象---兼談對人工智能研究的一些認識
對很多人來說,讓計算機也學會取象,這個聽起來很玄,其實這事一點也不難,明白了原理也就簡單了。 易學中的類象,從抽象的角度來說,其實就是一種對於萬事萬物的歸類,由於聖人觀陰陽之開闔以命物的緣故,人類在對客觀世界中所感知的事物進行起名的時候,總會依照某種直覺性的規律。 而這種規律是超越語言性的,在近代來的研究的語言翻譯模型,也能夠能夠發現類似的有趣情況,針對兩種語言之間的翻譯的模型,可以遷移到另外兩種
批處理FFMPEG切割視頻
原按網上的搜索的方法,然在切開視頻後,h5上不能播放,後查乃是各瀏覽器支持的h264編碼有要求,特別是ios之safari要求更為嚴格,故記之如下: setlocal enabledelayedexpansion set x=0 for %%i in (.\bazhi\*) ^ do ( set /a x+=1 set new_dir=G:\\course\\bazhi\\!x! mkdir !n
小樣本情況下使用SVM的思考
今日在驗證測試數據時,發現當採用cross_val_score進行交叉驗證時,對於隨機分配的測試集比例越大,正確率便越高,而測試集越小,平均正確率就越有可能低。 使用svm推導模型時,有兩個大坑,一個是train_test_split後,當數據量不夠時,學習到的樣本分佈差異很大,極不穩定,如何才是最優的train_test_split分法,很難確定,然後就是模型的泛化能力的評估是否可靠,這一塊又與
.net core 調用 winrt 運用時的關鍵
這兩日想寫一個簡單的視頻合成的小工具,如果不是為了分發使用,直接腳本ffmepg或直接用python便能完成了,然而現在遇到這樣需要,所以考慮直接用.net+winform的形式快速完成。 看到win rt裡的視頻編輯頗為簡單,於是打算直接用win ui3寫個小工具,結果發現這東西,跟ump不清不楚的關係,由於是自用,部署起來超級麻煩,而最簡單的方法是發佈到微軟應用商店,然後再下載,這是在開什麼玩
vs code 中 jupter notebook 提示Kernel died with exit code 1 解決
提示 Kernel died with exit code 1時 錯誤類似如下形式: traitlets.py: 2195: FutureWarning: Supporting extra quotes around Unicode is deprecated in traitlets 5.0. Use 'hmac-sha256' instead of '"hmac-sha256"' – or u
 編程筆記
R Studio在Windows 10下繪圖不清晰之解決
首先安裝R: sudo apt-get install r-base 在安裝後,如果在Windows10下R studio中,繪圖頗不清晰,所繪之圓及線條,邊緣頗有鋸齒,故改用wsl2,並以ubuntun為後端,改用R Studio Server。 sudo apt-get install gdebi-core wget https://download2.rstudio.org/server/b
因果圖(Causal Diagrams)的十個要點
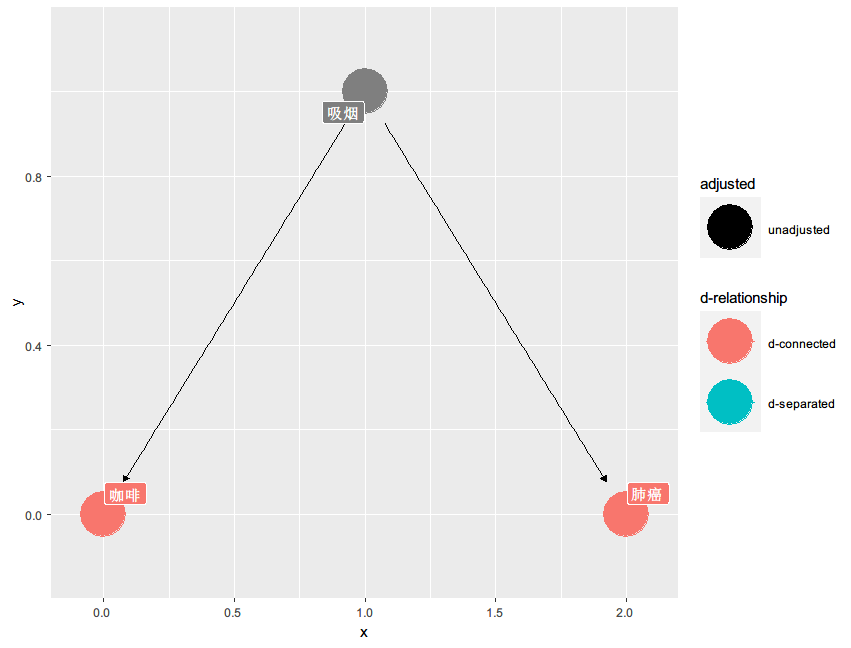
對於事件建模,如果可能,儘量構建有向無環圖(DAG) 1) DAG 上的每個節點對應於隨機變量,而不是其實現值 2) DAG中箭頭的存在或缺失與人口中存在或不存在個別因果關係相對應 3) "不可操縱"變量及其箭頭應小心繪製 4) 最好為總人口繪製 DAG,而不是為暴露或未曝光的群體繪製 DAG,這樣可以更好確定是否出現偏差 5) DAG主要有助於研究在期望中混淆的概念中在分配中是否存在混淆 6)
 編程筆記
五角星局部面積
[latex] \frac{10 \tan\left(\frac{\pi}{10}\right)}{3-\tan^2\left(\frac{\pi}{10}\right)} r^2 [/latex] 其它性質: 內部六邊形內角為:(n-2)* 𝛑) / n 每個標記角為:每個標記角度均為 3𝛑 / 5
Linux上的swap最佳速度設置
vi test.sh #!/bin/bash # Since we're dealing with dd, abort if any errors occur set -e TEST_FILE=${1:-dd_ibs_testfile} if [ -e "$TEST_FILE" ]; then TEST_FILE_EXISTS=$?; fi TEST_FILE_SIZE=134217728 # E
有趣:讓人工智能的GPT2讀道經
玩了一下Open AI的人工智能的GPT-3引擎 ,GPT-3的與眾不同之處在於它的運行規模和完成一系列令人難以置信的任務,很多人體驗後紛紛呼喊說未來搞文字寫作的怕是要失業了。 又用GPT-2的清源的CPM中文模型試了一下,發現效果很令人出乎意料,可以說實際效果讓人震驚。 比如: 輸入:“經過泥濘不堪的小路,來到了故鄉的小石橋",剩下的讓AI續,會寫出這樣的內容: 經過泥濘不堪的小路,來到了故鄉的
npm run build後,在docker中使用alpine及nginx作為http服務
為了實現簡單的ci配置,提交代碼後自動編譯並部署到目標服務器上,部署好gitea及jenkins後,還需要進一步處理才可將此步驟。 如用node.js中使用npm build後,於dist目錄中可得純屬html代碼,如用npm install http-server -g,其docker鏡像頗大,高達100M,故而改用alpine配合nginx進行目標部署,基本容量可降至13M。 mkdir pr
pytorch 在conda下載並離線安裝
1、安裝anconda 2、添加清華鏡像 conda config --add channels https://mirrors.tuna.tsinghua.edu.cn/anaconda/pkgs/free/ conda config --add channels https://mirrors.tuna.tsinghua.edu.cn/anaconda/cloud/conda-forge co
Flutter配置
見到Flutter頗為有趣,不禁下載一試,當下完android studio之後,又用visual studio code,安裝flutter插件,按說明直接F5卻無法運用,無奈又接真機試了一試,仍舊無法。 需按如下步驟,才可一次調通: 1、下載android studio 2、下載flutter 3、增加環境變量 4、下載並配置gradle,直接在在setting中設置,以免wapper下載過慢
量子計算與四象(三)
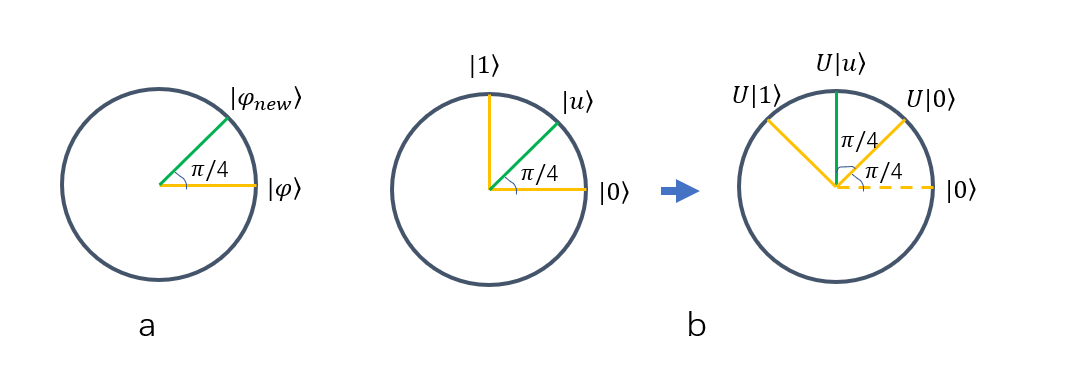
拋開所有的數學公式,只是純粹考察量子比特的話,其實更加的直接。 在一對量子中的其中一個量子,相當於有六種狀態,分別是 |0>,|1>,|+>,|->,|i>,|-i>,而這六種狀態可以用泡利圓來進行直觀表達,但是在考察時,按量子對而言,所以量子狀態的組合相當於有36種。 首先 |0> = [1,0] |1> = [0,1] 分別為|0>與|1>狀態,也就是前文說過的陰態與陽態。 處於|0>與|0>
 編程筆記
量子計算與四象(二)
如果把量子操作視作類似電路那樣的話,因為單個量子比特不但有陰態還有陽態以及混合態,要實現可控性可以利用其中的相互作用來實現控制。 所以可以設計進行邏輯控制的門,那麼需要操作的最基礎為四種情況:不變,翻轉,等0,等1。 簡單說操作其實就是控制一個量子態轉換成另外一個量子態,這個過程可以稱為演化,而演化,實際上就在Hilbert空間中的旋轉。 而在Hilbert空間中的旋轉可以使用矩陣來進行,而矩陣使
量子計算與四象(一)
一般的比特位只有0與1兩種狀態,而量子比特卻能有更多的狀態,但它同樣有0與1的兩種情況,通常記錄為 |1> 或 |0>這兩種態,如果使用矩陣的表示話,它們分別是: [latex] |0\rangle = \begin{bmatrix} 1 \\ 0 \\ \end{bmatrix} [/latex] [latex] |1\rangle = \begin{bmatrix} 0 \\ 1 \\ \en
共 101 篇